User-Agent可以被伪造,不能仅凭“Googlebot”文字就放行。可按官方方法做反向与正向DNS核对,或匹配当前对应爬虫的官方IP范围。不同爬虫与用户触发的读取工具有不同类别,验证时必须选择正确范围,并保留核对结果。
规则依据:Google Crawling:验证Google请求。
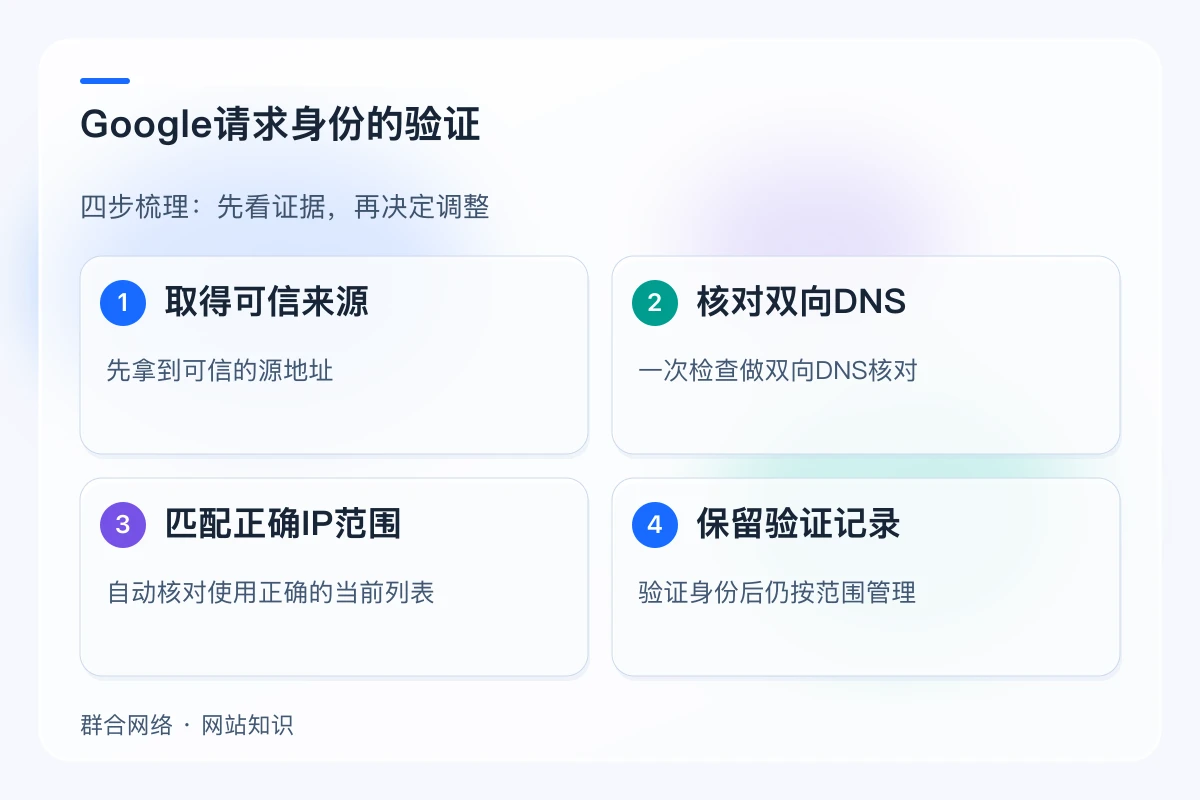
先拿到可信的源地址
从实际接收请求的服务器或可信代理链读取来源IP,注意未经信任的请求头也可能被伪造。保存时间、路径及规则命中情况,避免把一个客户端提交的转发地址当作真实来源。多层CDN环境需要先明确哪一层日志可信,才能进行身份验证。
一次检查做双向DNS核对
对来源IP进行反向DNS查询,检查返回主机名是否属于相应官方域名,再对该主机名做正向查询,确认地址对应原来源IP。域名必须按完整边界核对,不能只看字符串含有googlebot.com,因为攻击者可以在其他域名中使用类似字样。
自动核对使用正确的当前列表
批量验证可按官方发布的爬虫或读取工具IP范围进行匹配。普通爬虫、AdsBot等特殊爬虫与用户触发的工具属于不同类别,不能混用一个列表后宣称覆盖全部Google访问。列表应有更新机制,也不能将所有Google云用户地址都当作可信搜索爬虫。
验证身份后仍按范围管理
身份核对是访问规则的依据之一,不代表允许无限请求或访问私密页面。保留必要的负载保护,并按公开内容的用途处理。记录验证方法、列表版本及实际结果;无法确认的请求应标为未确认,而不是为了报表完整将所有类似名称都计算为Google抓取。
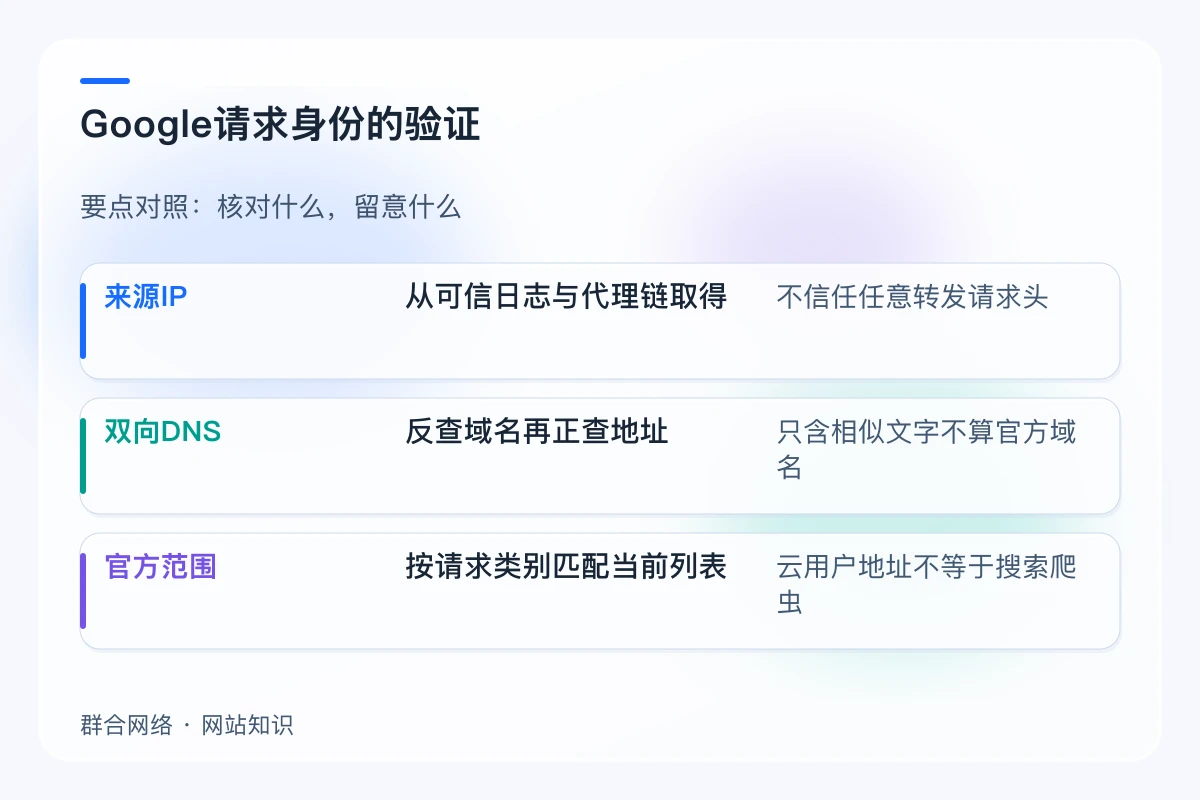
重点对照
| 信息项 | 核对内容 | 需要注意 |
|---|---|---|
| 来源IP | 从可信日志与代理链取得 | 不信任任意转发请求头 |
| 双向DNS | 反查域名再正查地址 | 只含相似文字不算官方域名 |
| 官方范围 | 按请求类别匹配当前列表 | 云用户地址不等于搜索爬虫 |
常见问题
改User-Agent模拟Googlebot就能测试真实抓取吗?
只能测试某些基于标识的规则,不能模拟真实来源网络和身份。
通过身份验证就应该绕过所有安全限制吗?
不应如此。公开资源可按需要允许读取,但负载、权限和私密内容仍需正常管理。