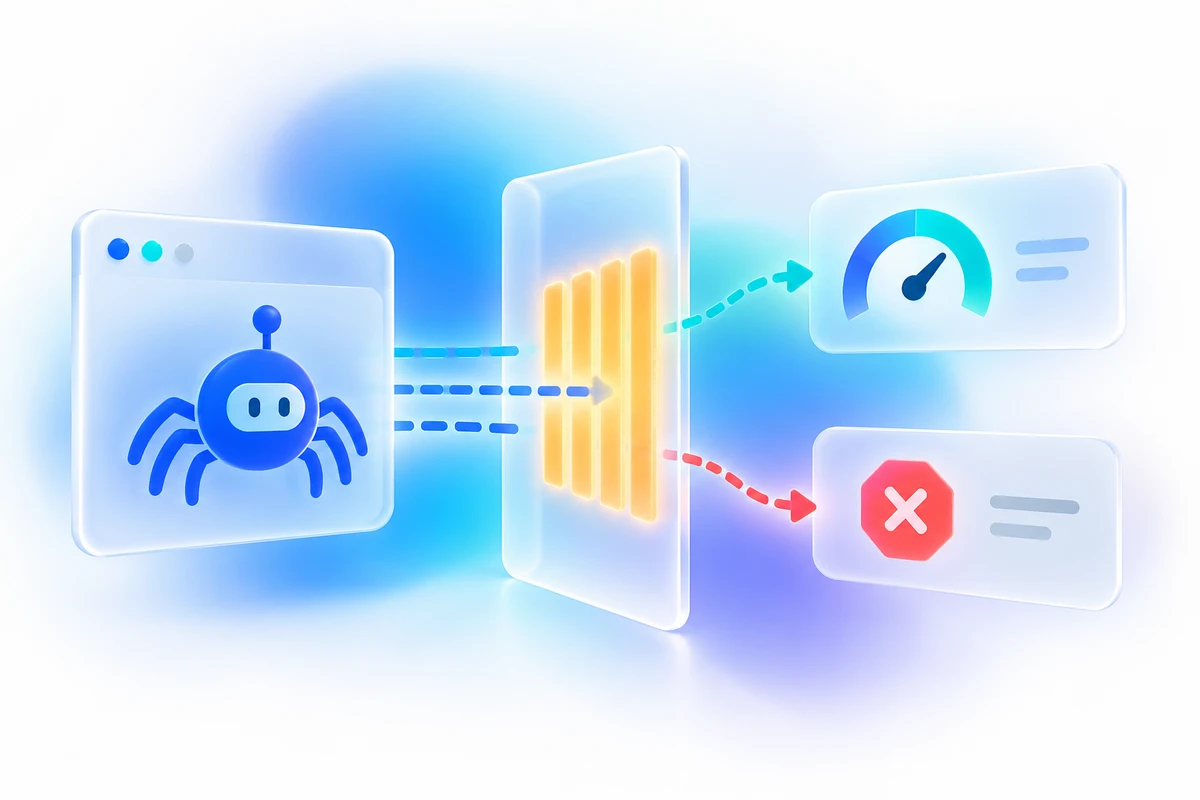
429表示请求过多,Google爬虫会将它视为服务器过载信号并放慢抓取。应先确认真实请求来源与限流规则,再修复容量或误拦问题。不能通过把所有爬虫改回200伪装正常,也不应长期用403来控制抓取速度。
规则依据:Google Crawling:HTTP状态码的影响。
先定位429由哪一层产生
查看服务器、CDN、防火墙或应用层日志,找到出现状态的时间、路径和规则。只看网站首页现在正常,不能证明文章、图片或robots.txt没有被限流。将请求标识与实际来源分开记录,自称Googlebot的User-Agent不是身份验证证据。
按真实负载与误拦分别处理
确实过载时,检查缓存、慢请求和资源容量,使用适当的临时响应管理压力;误将正常爬虫纳入过严规则时,在验证来源后调整具体规则。不要直接关闭全部安全措施,也不要无限制放行任何包含“Google”文字的请求。调整需要有范围和回退记录。
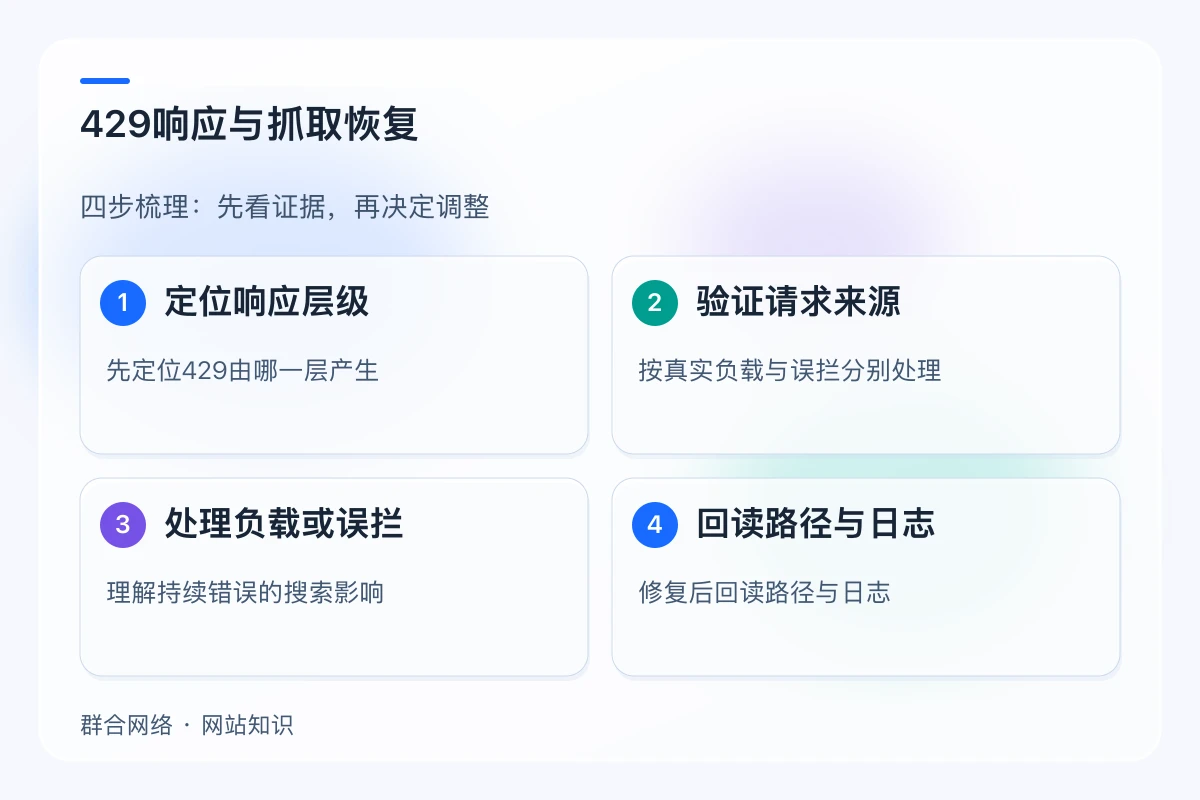
理解持续错误的搜索影响
官方说明指出,429与服务器错误会使爬虫暂时降低速度;持续错误可能最终影响已索引页面。403等状态不能简单替代429用于减速,它们会传达不同信息。对真正已删除的页面又应使用适当的不存在状态,不能为了保护索引一律返回空200页面。
修复后回读路径与日志
检查先前受影响页面和资源的响应,再观察后续真实请求是否恢复正常。测试时伪装User-Agent只验证规则的一部分,不能证明真实Google网络已经访问成功。记录当前可用性、真实日志证据和仍待观察的搜索变化,避免把本机测试一次通过就报告成全站抓取完全恢复。
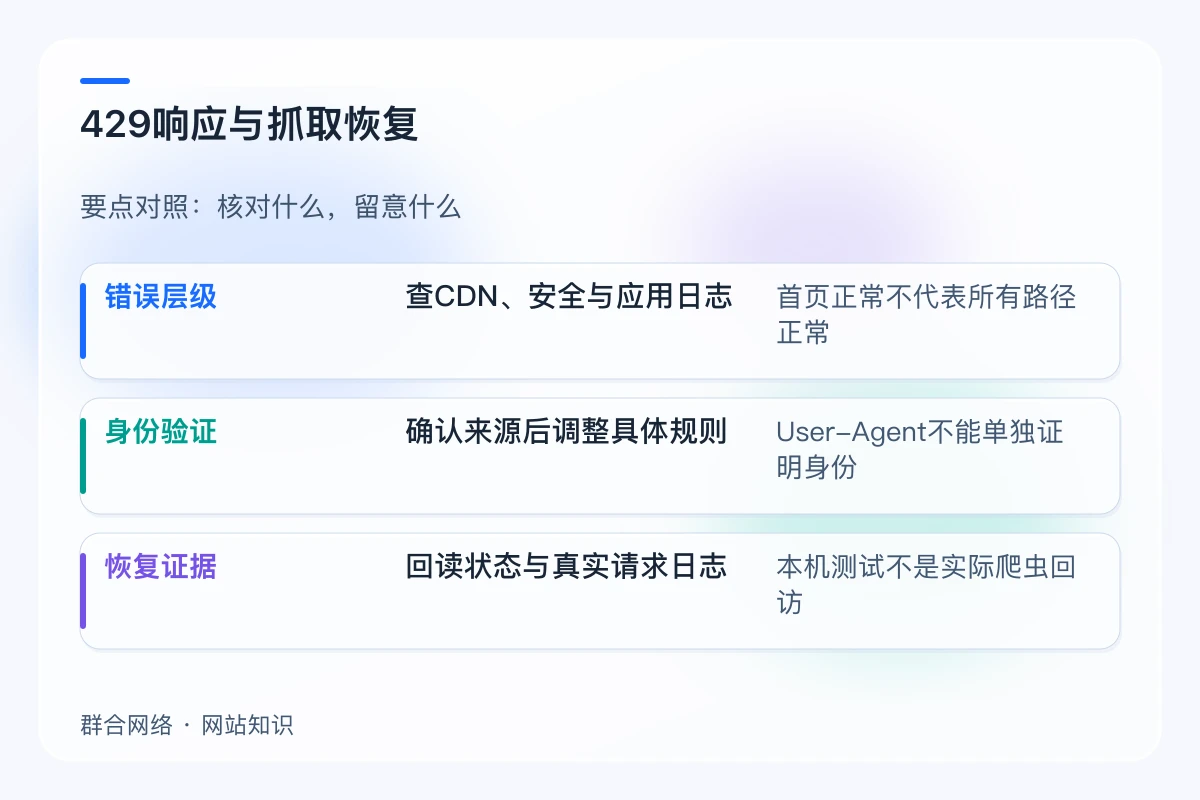
重点对照
| 信息项 | 核对内容 | 需要注意 |
|---|---|---|
| 错误层级 | 查CDN、安全与应用日志 | 首页正常不代表所有路径正常 |
| 身份验证 | 确认来源后调整具体规则 | User-Agent不能单独证明身份 |
| 恢复证据 | 回读状态与真实请求日志 | 本机测试不是实际爬虫回访 |
常见问题
用403限制Googlebot更安全吗?
不能作为控制抓取速度的直接替代。它与过载信号含义不同,应按适用方法处理。
429修复后排名会立刻恢复吗?
不能保证。需要重新抓取和处理,并结合其他因素观察搜索结果。