
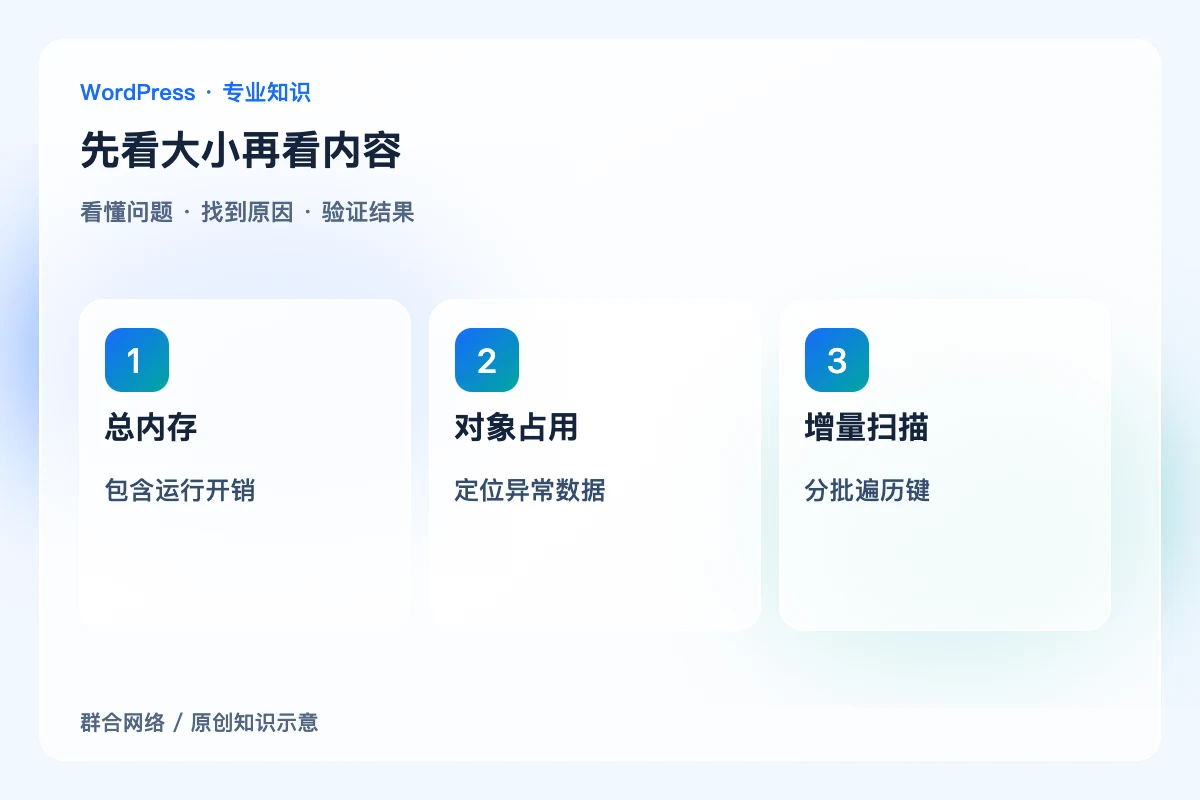
先用统计与受控抽样定位键的类型、数量和内存占用,再回到产生该缓存的代码查原因。不要直接导出所有值或在生产环境执行长时间阻塞扫描。大对象可能来自整批查询结果、重复结构或失控增长,不能只靠加内存处理。
先确认增长属于哪个阶段
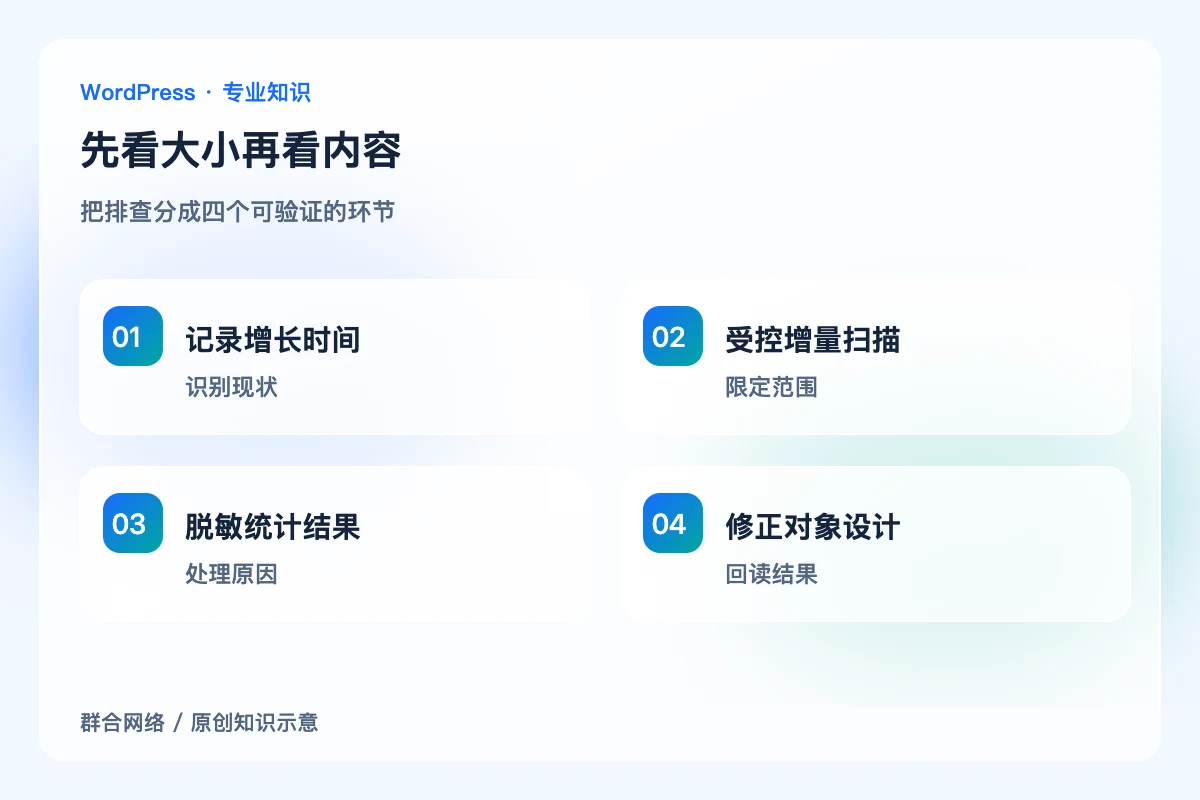
记录内存增长时间与发布、导入、定时任务等变化,区分键数量增加和少数键膨胀。Redis内存统计还包含运行开销,不能把总内存直接等同于业务值大小。按同一时间窗口采样,避免把重启、持久化或流量波动造成的变化混入结论。
扫描也有负载成本
使用适合当前规模的增量遍历和统计工具,控制批次与采样频率。SCAN不是一次全量快照,数据变化时会存在重复或遗漏,需要按其语义解读。不要为了找大键就执行可能阻塞的大范围KEYS,生产排查应先确认运维窗口与资源余量。
只拿足够判断的元信息
先看键类型、占用和有效期,键名本身也可能含用户标识或查询条件。对外输出使用脱敏样本与分布,不复制缓存值。若必须检查内容,限制权限和范围,在隔离环境使用非敏感样本复现,避免一次性能排查变成客户资料泄漏。
修复产生大对象的逻辑
定位到代码后检查是否一次缓存了全部记录、是否缺少分页、是否重复保存相同字段。拆分对象要同时设计失效,不能只把一个大键切成很多永不过期的小键。修改后比较总占用、命令数量与页面响应,防止节省内存却增加大量网络往返。
关键区别

总内存:包含运行开销;不能等于值大小。
对象占用:定位异常数据;不需公开内容。
增量扫描:分批遍历键;不是固定快照。
怎样确认处理到位
验证应覆盖同一业务操作后的对象大小与总内存变化,同时检查缓存失效和页面数据是否正确。报告保留分布与脱敏键样本,不附完整客户数据。
容易误判的边界
不要看到大键就立即删除,先确认是否可重建及影响范围。内存采样工具本身也有成本,不能在业务高峰无限循环扫描整个实例。


