
PDF等非HTML资源可以按官方支持方式通过HTTP Link头或站点地图表达语言版本关系,不需要在PDF里硬塞HTML标签。先确认文件确实对应同一内容和语言,再维护完整、可访问且相互一致的版本集合。
先整理真实文件版本
记录各PDF的语言、内容版本、公开URL和许可,确认它们确为对应翻译,而不是不同产品或不同修订。不能只因文件名带EN就标成英文版。产品参数和有效期需要与正文确认,不用hreflang掩盖内容版本不一致。
选择可维护的一种表达方式
Google说明HTML、HTTP头和站点地图等支持方法,非HTML文件可考虑适合的头部或地图方案。不要为了“更强SEO”无计划同时维护三套配置,增加遗漏。所用服务器、CDN和地图工具的能力需核实,不能把文章插件的HTML输出自动等同文件响应头。

按规范构建关联集合
语言代码和完整绝对URL应准确,各版本的自引用及互相对应按官方要求检查。被权限拦截、返回错误或已改名的文件不应继续留作有效替代。配置中不出现私有签名地址或短期链接,公开资料和客户专属文件要分开处理。
从每份公开文件回读
检查实际响应头或地图条目、最终文件语言与版本,确认CDN未删改或缓存旧关联。用户页面也应有清楚下载入口与语言标记,机器关联不能替代人能找到正确文件。技术成立不保证一定展示某语言,后续搜索表现需真实观察。
关键区别
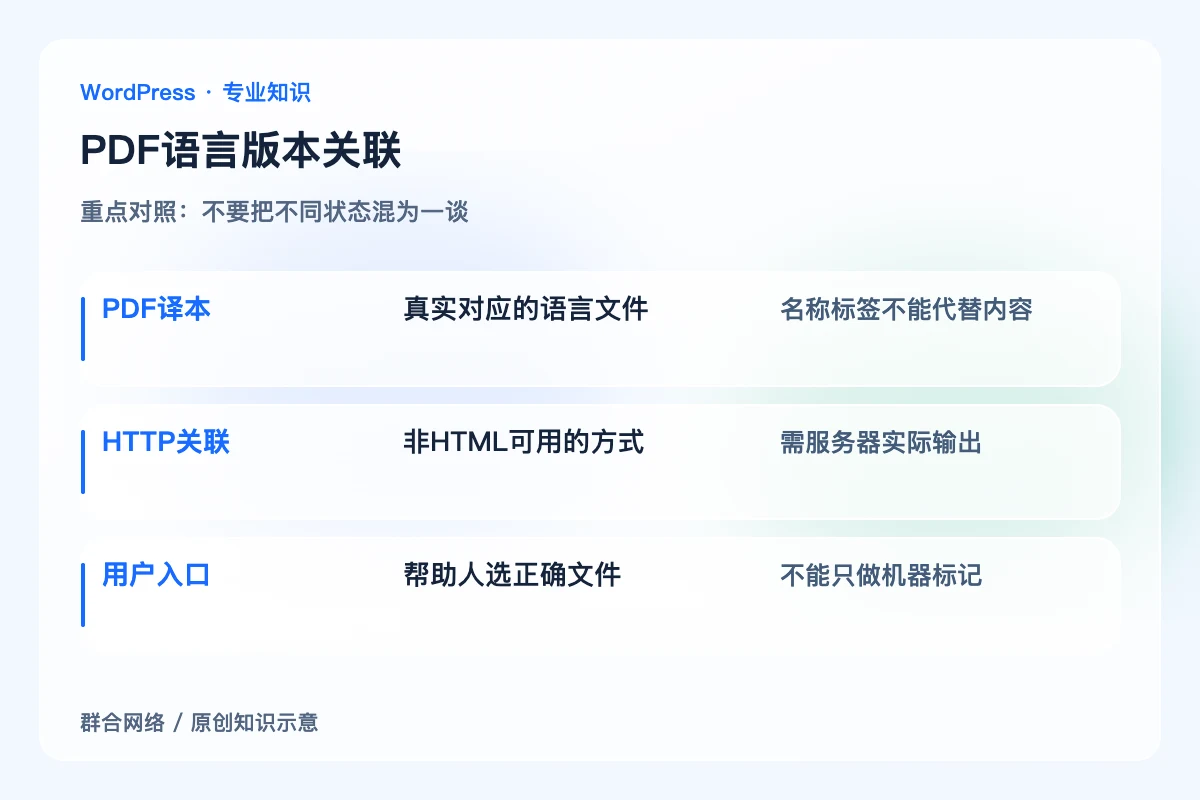
PDF译本:真实对应的语言文件;名称标签不能代替内容。
HTTP关联:非HTML可用的方式;需服务器实际输出。
用户入口:帮助人选正确文件;不能只做机器标记。
怎样确认处理到位
各公开PDF语言和版本真实对应,所选关联方式可读取且互相一致,URL长期可用,网页下载提示清楚,未将私有文件或过期版本公开关联。
容易误判的边界
非HTML语言关联和文件访问权限分别维护;本页处理真实译本之间的对应关系。没有实际译本时不创建虚假语言条目,也不保证搜索固定选用某份文件。


