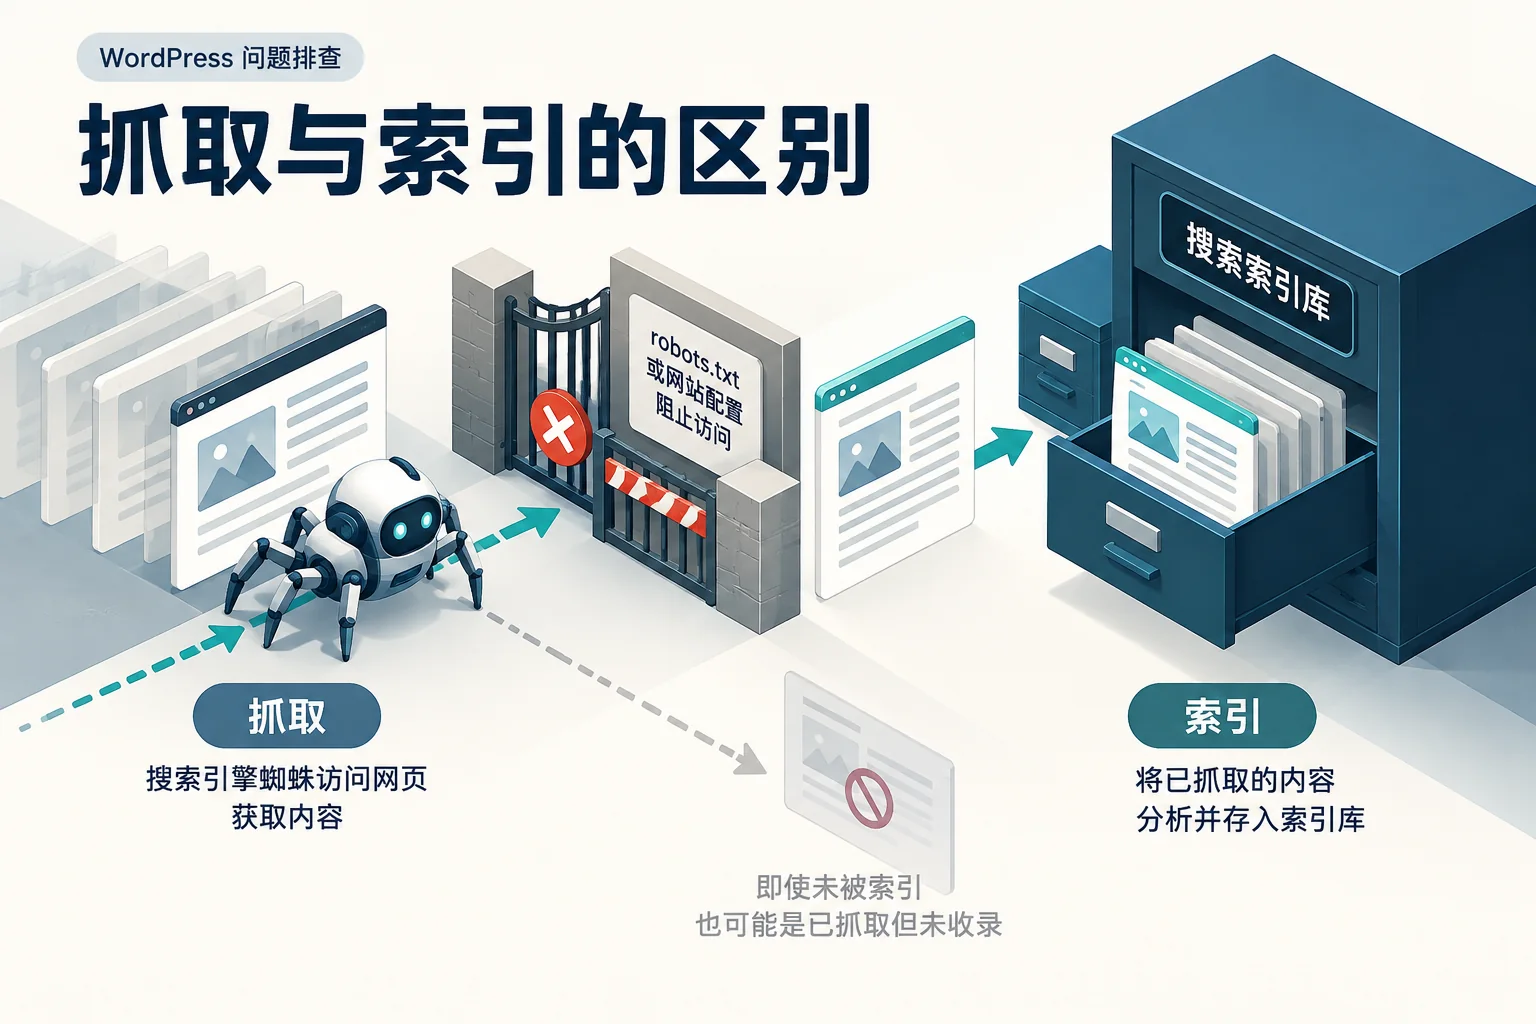
robots.txt的Disallow主要限制抓取,noindex用于表达不希望页面进入搜索索引。两者不是同一个开关。把页面禁止抓取后,搜索引擎可能无法看到页面里的noindex,URL仍可能因外部链接等信号出现。
根据目标选择方式
| 目标 | 应考虑的机制 |
|---|---|
| 公开页面不进入索引 | 可被读取的noindex指令 |
| 私密资料只让授权者查看 | 身份认证与权限控制 |
| 控制特定路径抓取 | 合理robots.txt规则 |
| 页面永久删除 | 正确404或410等实际状态 |
| 页面已迁移 | 对应页面的合理重定向 |
robots.txt是公开文件,不应用它隐藏秘密路径;搜索引擎遵守抓取规则,也不等于所有访问者都会遵守。
为什么“Disallow加noindex”可能适得其反
当爬虫不能获取页面内容时,就无法读取其中的meta noindex。若希望一个公开页面退出索引,需要让搜索引擎有机会访问并处理该指令。处理期间应观察抓取状态,而不是立即把入口封死。
敏感页面则应直接依靠认证与权限,不能为等待搜索引擎处理而继续公开数据。
WordPress维护时怎么查
检查站点根目录robots.txt的实际响应,以及SEO插件和服务器输出。文件可能是实体文件,也可能由WordPress动态生成。编辑了未生效的位置,结果不会改变。
核对规则匹配范围,尤其是通配符、目录和参数。不要为了屏蔽测试路径意外禁止整个站点,也不要把正常渲染所需资源全部拦住。
验证需要两类证据
一类是当前URL是否可抓取,另一类是是否允许索引。使用Search Console分别查看,不要把“可访问”理解为“一定收录”,或把“禁止抓取”理解为“已经从结果删除”。
对急需从搜索结果暂时隐藏的URL,可了解搜索平台的移除工具,但它不能替代源站的长期访问或索引策略。
robots.txt里写noindex可以吗? 不应把它当作Google支持的noindex实施方式。应使用页面meta或HTTP响应头等官方支持的方法,并保证指令能被读取。
参考资料
相关问题
本文为通用排查指南,依据所列官方资料整理;菜单名称和行为可能随版本及主机环境变化。配图为AI生成的概念示意,不是实际故障截图。